Πόσες λέξεις έχει πραγματικά η ελληνική γλώσσα; Η απάντηση δεν είναι τόσο απλή όσο φαίνεται. Μια μεγάλη ψηφιακή καταγραφή που έγινε από ερευνητές του Οικονομικού Πανεπιστημίου Αθηνών εντόπισε περίπου 7 εκατομμύρια διαφορετικούς ελληνικούς λεκτικούς τύπους σε κείμενα του Διαδικτύου.
Ο αριθμός είναι εντυπωσιακός, αλλά χρειάζεται σωστή ερμηνεία. Δεν σημαίνει ότι υπάρχουν 7 εκατομμύρια διαφορετικές λέξεις σε ένα λεξικό. Στην καταγραφή μετρήθηκαν ξεχωριστά διαφορετικές μορφές της ίδιας λέξης, όπως για παράδειγμα «άνθρωπος» και «άνθρωποι».
Πώς προέκυψαν τα 7 εκατομμύρια;
Η συγκεκριμένη καταγραφή έγινε από την ερευνητική ομάδα «Εξόρυξης Δεδομένων» του Τμήματος Πληροφορικής του Οικονομικού Πανεπιστημίου Αθηνών, με επικεφαλής τον καθηγητή Μιχάλη Βαζιργιάννη.
Οι ερευνητές επεξεργάστηκαν τεράστιο όγκο ελληνικού διαδικτυακού περιεχομένου. Σύμφωνα με τα στοιχεία που δημοσιοποιήθηκαν το 2018, χρησιμοποιήθηκαν κείμενα από περίπου 170 εκατομμύρια ιστοσελίδες και σύγχρονες τεχνικές τεχνητής νοημοσύνης και εξόρυξης δεδομένων.
Το έργο συνδεόταν με τη δημιουργία ψηφιακών γλωσσικών πόρων για την ελληνική γλώσσα και πραγματοποιήθηκε στο πλαίσιο συνεργασίας με την Εθνική Βιβλιοθήκη της Ελλάδος.
Τι σημαίνει στην πραγματικότητα «7 εκατομμύρια λέξεις»;
Εδώ βρίσκεται η σημαντικότερη λεπτομέρεια. Ο αριθμός δεν αφορά 7 εκατομμύρια λήμματα, όπως θα τα βρίσκαμε σε ένα παραδοσιακό λεξικό.
Πρόκειται για περίπου 7 εκατομμύρια διακριτούς λεκτικούς τύπους. Έτσι, διαφορετικές κλιτές μορφές της ίδιας λέξης καταγράφονται χωριστά. Για παράδειγμα, «πανεπιστήμιο» και «πανεπιστημίου» υπολογίζονται ως δύο διαφορετικοί τύποι.
Το ίδιο μπορεί να συμβαίνει με διαφορετικούς χρόνους ρημάτων, πτώσεις ουσιαστικών, γένη, αριθμούς αλλά και με σύνθετες ή νεότερες λέξεις που εμφανίζονται στο Διαδίκτυο.
Επομένως, δεν είναι σωστό να συμπεράνουμε ότι η ελληνική διαθέτει ένα λεξικό με 7 εκατομμύρια διαφορετικά λήμματα.
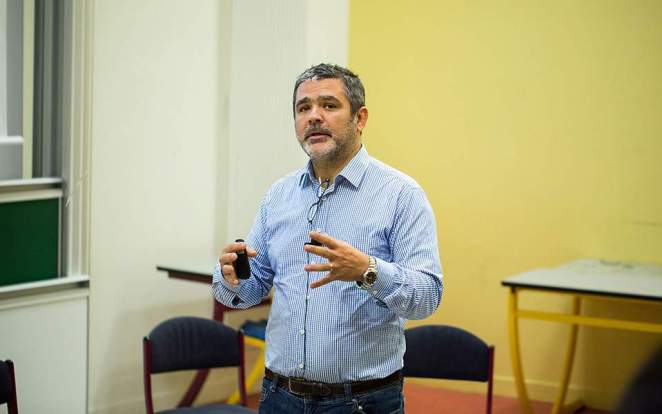
Ο καθηγητής Μιχάλης Βαζιργιάννης διευθύνει την ερευνητική ομάδα «Εξόρυξης Δεδομένων» του Τμήματος Πληροφορικής του ΟΠΑ.
Γιατί μια ψηφιακή καταγραφή βρίσκει τόσες πολλές μορφές;
Η ελληνική είναι μια γλώσσα με έντονη μορφολογία. Τα ουσιαστικά και τα επίθετα κλίνονται, ενώ τα ρήματα μπορούν να εμφανιστούν σε πολλές διαφορετικές μορφές ανάλογα με τον χρόνο, το πρόσωπο, τον αριθμό και την έγκλιση.
Παράλληλα, το Διαδίκτυο περιλαμβάνει τεχνικούς όρους, ορολογία επαγγελμάτων, διοικητικές λέξεις, νεολογισμούς, σύνθετες λέξεις και τύπους που μπορεί να μην εμφανίζονται στα συνηθισμένα λεξικά.
Ο καθηγητής Βαζιργιάννης είχε αναφέρει ως χαρακτηριστικά παραδείγματα λέξεις όπως «θερμογαλβανισμένη» και «ενταλματοποιηθέντα». Τέτοιοι τύποι μπορεί να χρησιμοποιούνται σε πραγματικά κείμενα παρότι δεν εμφανίζονται ως ξεχωριστά λήμματα σε ένα παραδοσιακό λεξικό.
Ένα λεξικό που παρακολουθεί τη σύγχρονη γλώσσα
Ένα από τα ενδιαφέροντα στοιχεία της συγκεκριμένης προσπάθειας είναι ότι το υλικό προήλθε από το Διαδίκτυο. Έτσι, αντί να εξετάζεται μόνο η γλώσσα των βιβλίων και των παραδοσιακών λεξικών, καταγράφονται λέξεις που χρησιμοποιούνται πραγματικά σε σύγχρονα ψηφιακά κείμενα.
Αυτό επιτρέπει στους ερευνητές να εντοπίζουν νέες λέξεις και μορφές που δημιουργούνται καθώς αλλάζουν η τεχνολογία, η επιστήμη, η διοίκηση και η καθημερινή ζωή.
Ο ίδιος ο καθηγητής είχε χαρακτηρίσει το αποτέλεσμα πιθανότατα ως το μεγαλύτερο ψηφιακό λεξιλόγιο ελληνικών που είχε δημιουργηθεί μέχρι τότε.
Τι είναι τα word embeddings;
Η ομάδα δεν περιορίστηκε στην καταγραφή των λέξεων. Ανέπτυξε επίσης διανυσματικές αναπαραστάσεις λέξεων, γνωστές ως word embeddings.
Με απλά λόγια, η τεχνολογία αυτή μετατρέπει τις λέξεις σε αριθμητικές αναπαραστάσεις. Με βάση τον τρόπο και τα συμφραζόμενα στα οποία εμφανίζονται μέσα σε πολλά κείμενα, ο υπολογιστής μπορεί να υπολογίζει ποιες λέξεις παρουσιάζουν μεγαλύτερη σχέση μεταξύ τους.
Για παράδειγμα, οι λέξεις «Ελλάδα» και «Αθήνα» εμφανίζονται συχνά σε σχετικά συμφραζόμενα και έτσι το σύστημα μπορεί να αναγνωρίσει ότι έχουν μεγαλύτερη σημασιολογική σχέση από δύο εντελώς άσχετες λέξεις.
Τέτοιες τεχνικές χρησιμοποιούνται σε εφαρμογές επεξεργασίας φυσικής γλώσσας, στην αναζήτηση πληροφοριών και σε συστήματα τεχνητής νοημοσύνης.
Η έρευνα της ομάδας πέρα από τις λέξεις
Η ερευνητική ομάδα του ΟΠΑ έχει ασχοληθεί επίσης με την ανάλυση γραφημάτων και άλλες τεχνικές επιστήμης δεδομένων.
Τα γραφήματα χρησιμοποιούνται για να περιγράψουν σύνθετες σχέσεις. Σε ένα κοινωνικό δίκτυο, για παράδειγμα, κάθε χρήστης μπορεί να θεωρηθεί ένας κόμβος και οι σχέσεις ή οι αλληλεπιδράσεις μεταξύ των χρηστών οι συνδέσεις μεταξύ αυτών των κόμβων.
Παρόμοιες τεχνικές μπορούν να εφαρμοστούν σε δίκτυα μεταφορών, οικονομικές συναλλαγές, συστήματα πληροφοριών και πολλούς άλλους τομείς.
Το 2018 η ομάδα απέσπασε επίσης βραβείο καλύτερης επιστημονικής δημοσίευσης στο διεθνές συνέδριο τεχνητής νοημοσύνης IJCAI. Η διάκριση αυτή αφορούσε το ευρύτερο ερευνητικό έργο της ομάδας και δεν πρέπει να συγχέεται με την ίδια την καταγραφή των 7 εκατομμυρίων λεκτικών τύπων.
Έχει λοιπόν η ελληνική γλώσσα 7 εκατομμύρια λέξεις;
Αν με τη λέξη «λέξεις» εννοούμε διαφορετικούς λεκτικούς τύπους που εντοπίστηκαν σε ένα τεράστιο σώμα ελληνικών διαδικτυακών κειμένων, η συγκεκριμένη καταγραφή έφτασε πράγματι περίπου στα 7 εκατομμύρια.
Αν όμως εννοούμε 7 εκατομμύρια διαφορετικά λήμματα με ξεχωριστή σημασία, η απάντηση είναι όχι. Ο αριθμός δεν μπορεί να συγκριθεί άμεσα με τον αριθμό λημμάτων ενός συμβατικού λεξικού.
Αυτό δεν κάνει το αποτέλεσμα λιγότερο ενδιαφέρον. Αντίθετα, δείχνει πόσο μεγάλη ποικιλία μορφών εμφανίζει η ελληνική γλώσσα στην πραγματική χρήση της και πόσο γρήγορα μπορεί να εμπλουτίζεται το ψηφιακό της λεξιλόγιο με νέους όρους και νέες μορφές.
Η συγκεκριμένη καταγραφή δείχνει επίσης κάτι ακόμη σημαντικό: οι νέες τεχνολογίες μπορούν να μας βοηθήσουν να μελετήσουμε την ελληνική γλώσσα σε κλίμακα που θα ήταν πρακτικά αδύνατη με τις παραδοσιακές μεθόδους.